明日の運動会、花火大会、開催される?されない?〜二項ロジスティック回帰分析によるクラス分類〜
運動会や花火大会って、当日になるまで開催されるのかがわかりません。それは天候に左右されるからですが、 例えば 「購入される・されない」「合格する・しない」も同じようなことで、 こんな風に「yes」or「no」を予測したい時があります。
今回はロジスティック回帰分析を用いてイベントの発生有無を予測してみます。
ロジスティック回帰分析
ロジスティック回帰分析は、複数の説明変数からイベントが発生する確率をモデル化する統計モデル。
「イベントの発生」とは、そのイベントが起こる・起こらないを表す。つまり「勝つか負けるか」「選択されるかされないか」のようなこと。
イベントが発生する確率をモデル化することで、ある事象においての、説明変数によって着地する結果について予測・説明を行う分析手法。
結果となる目的変数が 2 値の場合を「二項ロジスティック回帰」といい、結果となる目的変数が 3 値以上の場合を「多項ロジスティック回帰」という。
ロジスティック回帰分析は、以下に分類される。
- 二項ロジスティック回帰(Binomial Logistic Regression)
- 結果となる目的変数が 2 つ
- 勝ち or 負け
- 合格 or 不合格
- 購入する or 購入しない
- 結果となる目的変数が 2 つ
- 多項ロジスティック回帰(Polytomous Logistic Regression)
- 結果となる目的変数が 3 つ以上
- その画像は「猫 or 犬 or ライオン」
- 移動手段は「車 or 電車 or 飛行機」
- 結果となる目的変数が 3 つ以上
- 順序ロジスティック回帰(Ordinal Logistic Regression)
- 結果となる目的変数が順序変数かつ 3 つ以上
- 1 位 or 2 位 or 3 位
- 良い or まあまあ or 悪い
- 結果となる目的変数が順序変数かつ 3 つ以上
- 条件付きロジスティック回帰(Conditional Logistic Regression)
- 対応のあるデータ・マッチングされたデータに対して二項ロジスティック回帰を実施する
- クラスタ、ないしペアを指定する
一般に「ロジスティック回帰」と言うと二項ロジスティック回帰を指す事が多いようです。(本記事でも「ロジスティック回帰=二項ロジスティック回帰」として進めます)
機械学習では「教師あり学習」に分類される。
花の種類を予測する
サンプルのデータセットとして今回は、カルフォルニア大学(UC バークレー)から公開されている「アヤメのデータセット」を利用します。
Iris Data Set - UCI Machine Learning Repository
次でデータの内容を確認していきますが、このデータセットの中にはアヤメという花の情報と、そのアヤメの種類が収録されています。
アヤメに関する情報から、そのアヤメがどの種類(A or B)のアヤメなのかを予測するモデルを作成します。
データ確認
データセットの中身を確認します。
CSV をダウンロードしてきて読み込んでも良いですが、Iris データセットは Seaborn や scikit-learn にも収録されているので、今回は Seaborn から取得し読み込んでいきます。
https://github.com/mwaskom/seaborn-data
import seaborn as sns
df = sns.load_dataset('iris')

df.head()
| sepal_length | sepal_width | petal_length | petal_width | species | |
|---|---|---|---|---|---|
| 0 | 5.1 | 3.5 | 1.4 | 0.2 | setosa |
| 1 | 4.9 | 3.0 | 1.4 | 0.2 | setosa |
| 2 | 4.7 | 3.2 | 1.3 | 0.2 | setosa |
| 3 | 4.6 | 3.1 | 1.5 | 0.2 | setosa |
| 4 | 5.0 | 3.6 | 1.4 | 0.2 | setosa |
各列の意味は以下の通り。
| en | ja |
|---|---|
| sepal_length | がく片の長さ (cm) |
| sepal_width | がく片の幅 (cm) |
| petal_length | 花弁の長さ (cm) |
| petal_width | 花弁の幅 (cm) |
| species | クラス(Setosa, Versicolor, Virginica) |
つまり「がく」や「花」の長さや幅によって種類を予測するモデルを作成します。
データでいうと目的変数は species になります。
データ整形
このデータには 3 品種のデータが収録されています。(Setosa, Versicolor, Virginica)
今回はわかりやすさ重視で、二項ロジスティック回帰で 2 値分類を実施するためにデータは 2 品種のアヤメに絞ります。
- Setosa:ヒオウギアヤメ
- 原産:日本・中国・北米
- Virginica:バージニカ
- 原産:北アメリカ東部
- Versicolor:バージカラー(ブルーフラッグ)
- 原産:北米
どれを抜こうか。素人目だと 3 種の違いは全くわからないですね。
原産にアジアを含まないということで今回は「バージニカ」か「バージカラー」かを分類したいと思います。(名前も似ていますし)
# versicolor と virginica のデータのみとし、Setosa のデータを取り除く。
df_iris = df.query('species in ["versicolor", "virginica"]')
df_iris.head()
| sepal_length | sepal_width | petal_length | petal_width | species | |
|---|---|---|---|---|---|
| 50 | 7.0 | 3.2 | 4.7 | 1.4 | versicolor |
| 51 | 6.4 | 3.2 | 4.5 | 1.5 | versicolor |
| 52 | 6.9 | 3.1 | 4.9 | 1.5 | versicolor |
| 53 | 5.5 | 2.3 | 4.0 | 1.3 | versicolor |
| 54 | 6.5 | 2.8 | 4.6 | 1.5 | versicolor |
Setosa のデータを取り除き、 versicolor と virginica のデータのみになりました。
(目的変数となる species を 2 値にできれば良い(virginica とそれ以外で分ける)のでデータ自体は省かなくても実施は可能)
記述統計量を確認
記述統計量を確認しておきます。
df_iris.describe()
| sepal_length | sepal_width | petal_length | petal_width | |
|---|---|---|---|---|
| count | 100.000000 | 100.000000 | 100.000000 | 100.000000 |
| mean | 6.262000 | 2.872000 | 4.906000 | 1.676000 |
| std | 0.662834 | 0.332751 | 0.825578 | 0.424769 |
| min | 4.900000 | 2.000000 | 3.000000 | 1.000000 |
| 25% | 5.800000 | 2.700000 | 4.375000 | 1.300000 |
| 50% | 6.300000 | 2.900000 | 4.900000 | 1.600000 |
| 75% | 6.700000 | 3.025000 | 5.525000 | 2.000000 |
| max | 7.900000 | 3.800000 | 6.900000 | 2.500000 |
相関関係確認
次に、ペアプロット図で説明変数同士の相関関係を見ておきます。(ロジスティック回帰も多重共線性に気をつける必要があるため)
import matplotlib.pyplot as plt
sns.pairplot(df_iris, hue='species')
plt.show()
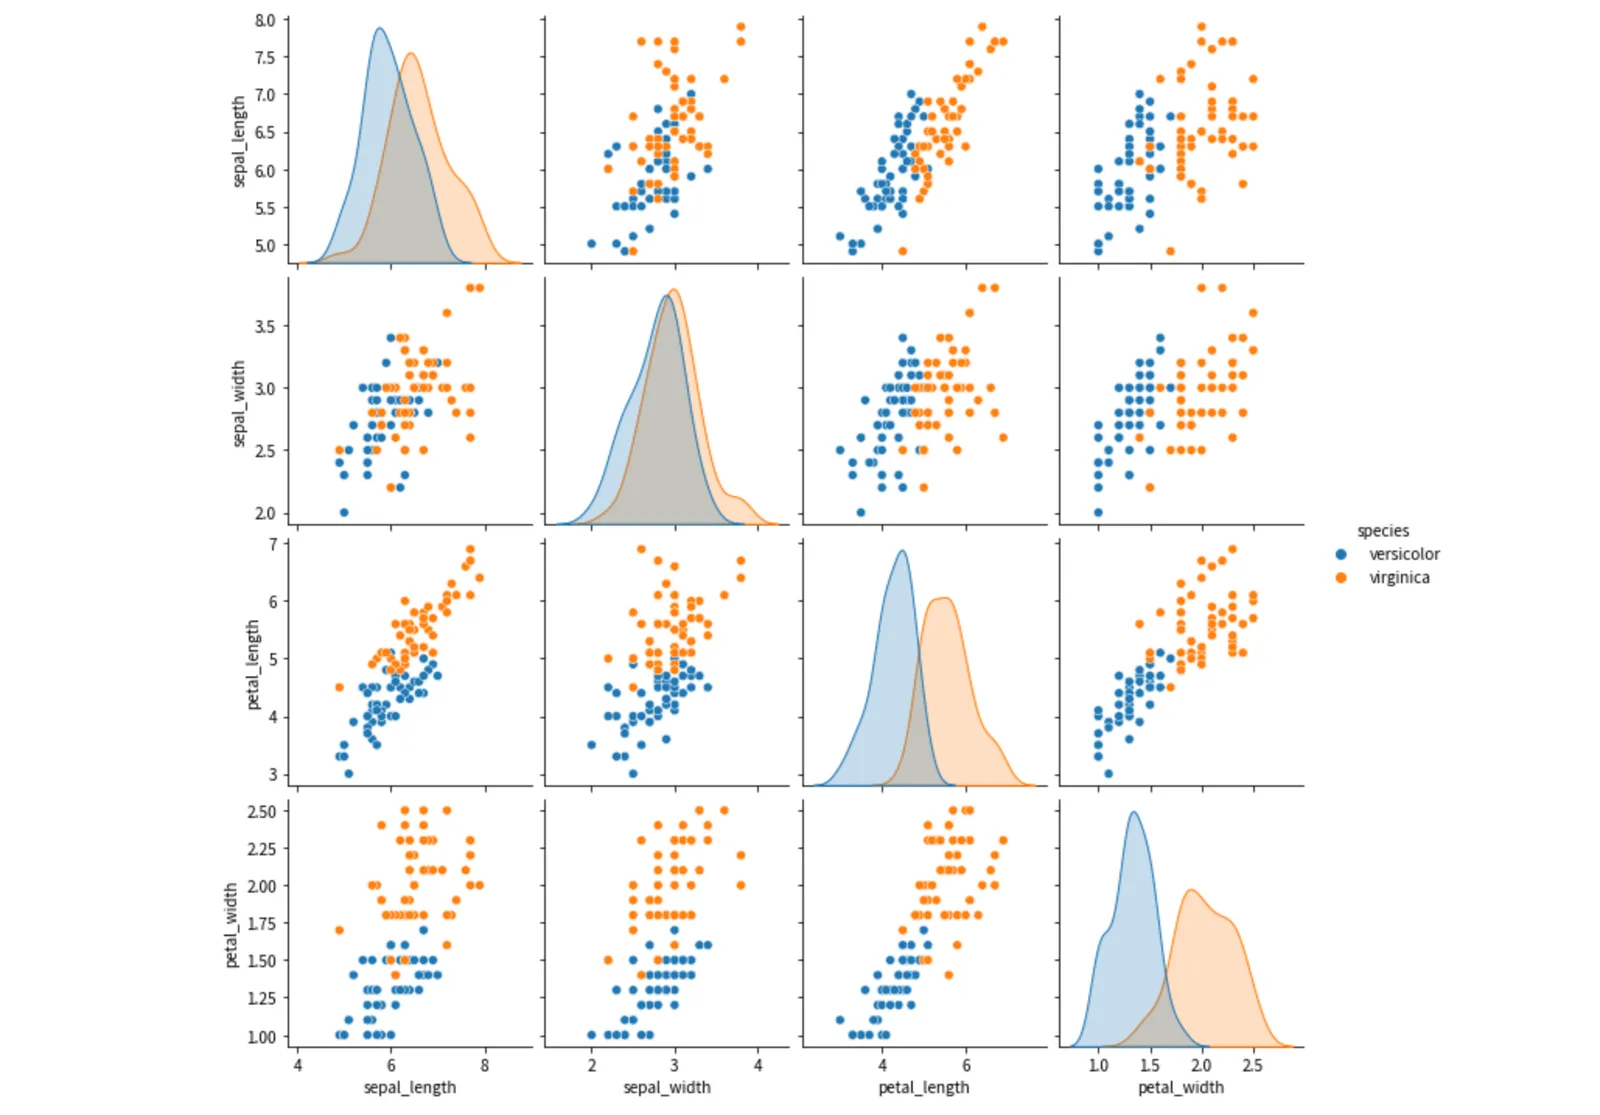
強めの正の相関が見受けられそうなところがあります。
それぞれの相関関係を出してみます。(pandas.DataFrame.corr)
df_except = df_iris.drop("species", axis=1) # 一旦 species を外して

df_except.corr() # 相関関係出力
| sepal_length | sepal_width | petal_length | petal_width | |
|---|---|---|---|---|
| sepal_length | 1.000000 | 0.553855 | 0.828479 | 0.593709 |
| sepal_width | 0.553855 | 1.000000 | 0.519802 | 0.566203 |
| petal_length | 0.828479 | 0.519802 | 1.000000 | 0.823348 |
| petal_width | 0.593709 | 0.566203 | 0.823348 | 1.000000 |
以下で強い正の相関が見られました。
- sepal_length(がくの長さ)× petal_length(花弁の長さ)=> 0.83
- petal_length(花弁の長さ)× petal_width(花弁の幅)=> 0.82
上記 2 つに共通する「petal_length」(花弁の長さ)を外すことで多重共線性を回避できそうです。
多重共線性を回避したことへのモデルの改善度合いも見たいので、一旦このカラムは削除せずこのまま分析を進め後半でここを除去することにします。
カテゴリ変数の数値化
最後に、カテゴリ変数 species を数値化しておきます。
現在、species には versicolor と virginica の 2 種類の値が入っています。
ロジスティック回帰にて 2 値分類を実施するために、目的変数となる species の値を 0, 1 に変換します。
# カテゴリ変数 species を数値化
#   species
#     versicolor: 0
#     virginica: 1
df_iris = pd.get_dummies(df_iris, drop_first=True, prefix='', prefix_sep='')

df_iris
| sepal_length | sepal_width | petal_length | petal_width | virginica | |
|---|---|---|---|---|---|
| 50 | 7.0 | 3.2 | 4.7 | 1.4 | 0 |
| 51 | 6.4 | 3.2 | 4.5 | 1.5 | 0 |
| 52 | 6.9 | 3.1 | 4.9 | 1.5 | 0 |
| 53 | 5.5 | 2.3 | 4.0 | 1.3 | 0 |
| 54 | 6.5 | 2.8 | 4.6 | 1.5 | 0 |
| ... | ... | ... | ... | ... | ... |
| 145 | 6.7 | 3.0 | 5.2 | 2.3 | 1 |
| 146 | 6.3 | 2.5 | 5.0 | 1.9 | 1 |
| 147 | 6.5 | 3.0 | 5.2 | 2.0 | 1 |
| 148 | 6.2 | 3.4 | 5.4 | 2.3 | 1 |
| 149 | 5.9 | 3.0 | 5.1 | 1.8 | 1 |
列名 species が virginica に変更され、値は 0, 1 になりました。
ロジスティック回帰では 2 値分類において
- イベントが発生する = 1
- イベントが発生しない = 0
を判別するため、ここではアヤメの種類が
- virginica である:1
- virginica ではない:0(つまりここではバージカラー)
となります。
データ書き出し
ここまで整形してデータを CSV に書き出しておきます(書き出さなくてもそのまま分析は進めらます)
import datetime

# ファイル名につける日時
dt_now = datetime.datetime.now().strftime('%Y%m%d_%H%M%S')

# csv ファイルに書き出し
df_iris.to_csv('data/iris' + dt_now + '.csv')
次のロジスティック回帰の実施ではこの csv データを変数 df に pandas.DataFrame で読み込んで実施します。
クラス分類の実施
データの準備ができたのでロジスティック回帰分析を行なっていきます。
Python を使い、機械学習ライブラリ Scikit-learn を利用して実行していきます。
df.head()
| sepal_length | sepal_width | petal_length | petal_width | virginica | |
|---|---|---|---|---|---|
| 0 | 7.0 | 3.2 | 4.7 | 1.4 | 0 |
| 1 | 6.4 | 3.2 | 4.5 | 1.5 | 0 |
| 2 | 6.9 | 3.1 | 4.9 | 1.5 | 0 |
| 3 | 5.5 | 2.3 | 4.0 | 1.3 | 0 |
| 4 | 6.5 | 2.8 | 4.6 | 1.5 | 0 |
データ分割
データを訓練用と検証用に分けます。(train_test_split)
from sklearn.model_selection import train_test_split

df_y = df.drop("virginica", axis=1)

X = df_y.values

Y = df['virginica'].values

# テスト用とデータを分割
x_train, x_test, y_train, y_test = train_test_split(X, Y, test_size=0.3, random_state=20)

print(x_train.size, x_test.size)
# -> 280 120
モデル作成
ロジスティック回帰モデルのインスタンスを作成し、モデルの重みを学習します。(LogisticRegression)
from sklearn.linear_model import LogisticRegression

lr = LogisticRegression()
lr.fit(x_train, y_train)
作成したモデルの係数と切片を確認します。
# 説明変数の係数
print("coefficient = ", lr.coef_)
# -> coefficient =  [[0.40765208 0.07823509 2.58973352 1.82137556]]

# 切片
print("intercept = ", lr.intercept_)
# -> intercept =  [-18.75990594]
- 係数
- sepal_length:0.40765208
- sepal_width:0.07823509
- petal_length:2.58973352
- petal_width:1.82137556
- 切片:-18.75990594
上記の切片や係数を持ったモデルが作成されました。
検証
作成したモデルに検証データを投入してアヤメの種類を予測します。
y_pred = lr.predict(x_test)

print(y_pred)
# -> [1 1 0 0 0 0 0 0 0 0 0 1 0 1 0 0 0 1 1 0 0 1 0 1 0 0 0 1 0 0]
予測結果が出力されました。検証データでは virginica ではない(=バージカラー)のものが多いようです。
ロジスティック回帰におけるモデルの性能評価
二項ロジスティック回帰によって 2 値分類を実施しました。
今回作成したモデルの性能評価(どの程度予測できているのか)を行っていきます。
ロジスティック回帰の性能を見るには以下の指標を確認します。
- 正解率
- 適合率
- 再現率
- F 値
- AUC
混同行列(Confusion Matrix)
「正解率」「適合率」「再現率」「F 値(スコア)」を算出する上で基となる混同行列を見ていきます。
混同行列は、2 値分類において実際の分類に対しての予測の分類を行列形式にまとめたものです。
| Positive (PP) | Negative (PN) | |
|---|---|---|
| Positive (P) | True positive (TP), 真陽性 | False negative (FN), 偽陰性 |
| Negative (N) | False positive (FP), 偽陽性 | True negative (TN), 真陰性 |
※ 行が実際の真偽を、列が予測の真偽を表す。
sklearn metrics の confusion_matrix で取得します。
from sklearn.metrics import confusion_matrix

# 混同行列
cm = confusion_matrix(y_true=y_test, y_pred=y_pred)

confusion_matrix(y_true=y_test, y_pred=y_pred)
# -> [[16  0] [ 5  9]]
confusion_matrix の出力では [[A B] [C D]] の行列で表し、それぞれ以下を意味します。
- A / 実態: 0, 予測:0 -> 実際には 0 だったものを正しく 0 と予測(分類) = TN
- B / 実態: 0, 予測:1 -> 実際には 0 だったものを誤って 1 と予測(分類) = FP
- C / 実態: 1, 予測:0 -> 実際には 1 だったものを誤って 0 と予測(分類) = FN
- D / 実態: 1, 予測:1 -> 実際には 1 だったものを正しく 1 と予測(分類) = TP
出力結果から、以下がわかります。
- TN / 16 -> 実際には versicolor だったものを正しく versicolor と予測
- B / 0 -> 実際には versicolor だったものを誤って virginica と予測
- C / 5 -> 実際には virginica だったものを誤って versicolor と予測
- D / 9 -> 実際には virginica だったものを正しく virginica と予測
本来 versicolor であるものは versicolor であると予測できているのに対し、本来 virginica であるものを誤って versicolor と予測してしまっているものが 5 つありますね。
バージカラーが多めだったのは、実際より多くバージカラーと予測されたことによるものだったようです。
ロジスティック回帰の注意点
今回は versicolor と virginica のみ且つシンプルなデータセットで実施しているため白黒がはっきりつき「誤った予測」と判断がつきますが、 ロジスティック回帰を用いる場合に必ずしもそのデータが白黒はっきりつく分類だけではないため、結果として「どういう方針で判定(予測)していくか」を調整していく必要があります。
例えば病気かどうかの判定などシビアな状況において「疑わしき」はどう判定するのが懸命か。疑わしきをスルーした場合、もし本当に病気だったのならば目も当てられません。
ただし、疑わしきを「病である」と判定すれば機械的な判定上では引っかかることになり、その後実際に検査して本当はどうかを確認できます。
ロジスティック回帰もあくまでも予測のため、完全に判定できない状況下では、誤って「イベントは発生する」と判断されることが必ずしも悪ではない。という状況があります。
ということから、ロジスティック回帰では状況に応じて判断の閾値を決めて実施していく必要があります(Scikit-learn の閾値はデフォルトは 0.5 でどちらにも寄っていない)。
ということを踏まえて、次からの指標を見ていきます。
正解率(Accuracy)
正解率は、全体に対してどれだけ正解(正しく分類)できたかの割合。
| Positive (PP) | Negative (PN) | |
|---|---|---|
| Positive (P) | True positive (TP) | False negative (FN) |
| Negative (N) | False positive (FP) | True negative (TN) |
読んで字の如しですが、正解したものを全体数で割ることで、正解した割合を算出します。
from sklearn.metrics import accuracy_score

# 正解率
accuracy_score(y_true=y_test, y_pred=y_pred)
# -> 0.833
正解率は 0.833 でした。2 割弱不正解。
適合率(Precision)
適合率は、Positive であると予測したデータのうち実際に Positive であると正解できたデータの割合。
| Positive (PP) | Negative (PN) | |
|---|---|---|
| Positive (P) | True positive (TP) | False negative (FN) |
| Negative (N) | False positive (FP) | True negative (TN) |
from sklearn.metrics import precision_score

# 適合率
precision_score(y_true=y_test, y_pred=y_pred)
# -> 1.0
適合率は 1.0 で満点。virginica と予測したものは全て実際に virginica であった。ということになります。
再現率(Recall)
再現率は、実際に Positive であるデータに対して、Positive であると予測し正解できたデータの割合。
| Positive (PP) | Negative (PN) | |
|---|---|---|
| Positive (P) | True positive (TP) | False negative (FN) |
| Negative (N) | False positive (FP) | True negative (TN) |
from sklearn.metrics import recall_score

# 再現率
recall_score(y_true=y_test, y_pred=y_pred)
# -> 0.642
再現率は 0.642 でした。3.5 割ほど Positive を Negative と判断した。 ここでは「本来は virginica のデータを 3.5 割ほど versicolor と判断した」ということになります。
F 値(F-measure)
F 値は適合率と再現率の調和平均。
一般に適合率と再現率はトレードオフの関係にあり、再現率を高めようとして積極的に positive 判定しようとすると誤った判定が多くなり適合率が下がっていく傾向にある。 (ロジスティック回帰の注意点での閾値の文脈)
F 値は調和平均によりこれらの指標のバランスをとった指標となっている。
適合率と再現率のどちらに重きを置くかはケースバイケースだが、事情がなければ F 値が最も高くなる閾値を選ぶのが一般的。 (scikit-learn での 2 値分類において predict した場合、デフォルトの閾値は 0.5 になっている)
from sklearn.metrics import f1_score

# F 値
f1_score(y_true=y_test, y_pred=y_pred)
# -> 0.782
F 値は 0.782 でした。ここはこの数値だけで見るというよりも、モデル改善(精度改善、閾値調整)を行なった上で比較して値を見ていきたいところです。
AUC(Area Under the Curve)
AUC は、曲線の下側の面積の大きさで分類予測を評価するもの。値が大きい=分類の性能が良い(max=1)といえる。
曲線の種類としては以下がある
- ROC(Receiver Operating Characteristic)曲線
- 横軸:偽陽性率(FPR)
- 縦軸:真陽性率(TPR)
- PR(Precision-Recall)曲線
- 縦軸:適合率
- 横軸:再現率
- positive ケースが少ない場合はこちらの方が良く可視化できる
- 異常検知とか、平時は negative 判定のものなど。
今回は ROC 曲線で見ていきます。
- ROC は、閾値を MAX(1.0) から下げていった時の、TPR と FPR の割合を曲線にしたもの。
- クラス分類ではそれぞれのデータにおいてイベントが発生する確率を算出し、それが閾値を超えていればイベント発生=クラス 1 に分類する。
- つまり閾値を変化させることによって 0, 1 への振り分け判定のラインが変わり、それは同時に真陽性率と偽陽性率の割合が変化することを意味する。
AUC を見る前に ROC 曲線を描いて見てみます。scikit-learn LogisticRegression の predict_proba でイベント発生確率を取得しています。
from sklearn.metrics import roc_curve, auc
import matplotlib.pyplot as plt

# イベント発生確率
y_score = lr.predict_proba(x_test)[:, 1]
fpr, tpr, thresholds = roc_curve(y_true=y_test, y_score=y_score)

plt.plot([0, 0, 1], [0, 1, 1], linestyle='--', label='ideal')
plt.plot(fpr, tpr, label='roc curve (area = %0.3f)' % auc(fpr, tpr))
plt.legend()
plt.xlabel('false positive rate(FPR)')
plt.ylabel('true positive rate(TPR)')
plt.show()
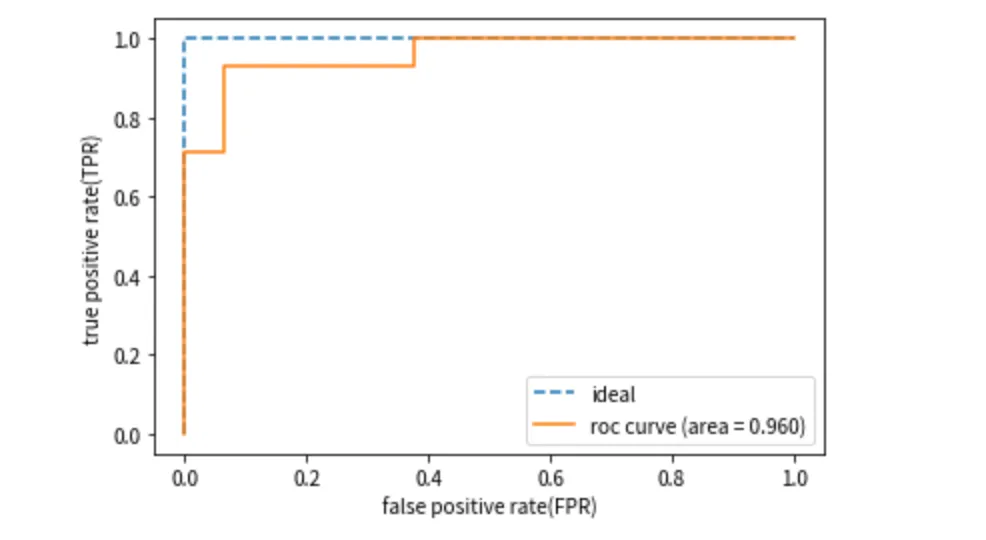
階段状に推移しているオレンジ色の線が ROC 曲線です。
今回の結果で見ると、序盤で 7 割強くらいは実際に 1 (=virginica)であったものは 1 で振り分けられていっています。
早い段階で 1 のものが 0 (=versicolor)と判断されはじめ(FPR = 0.08)、次第に増えていき(FPR = 0.4)、そして全てが 1 判定されました。
つまり ROC 曲線は、閾値を下げていった時に TPR が 1.0 であれば誤り無く全てが完璧に振り分けられたことになるため (0,1) (1,1) を通る曲線(というか直角の線)となります。そしてその時は (0,0) (1,1) 間の面積は最大となります。(グラフでいう ideal の青い破線)
そこから FPR の発生割合分、横方向に座標が移動するため曲線が緩やかに(というか直角の線から角が削がれて潰れていくようなイメージ)なっていくため、面積が小さくなる。
そしてこの面積が「AUC」となります。それでは AUC を算出します。
from sklearn.metrics import roc_auc_score

roc_auc_score(y_true=y_test, y_score=y_score)
# -> 0.960
AUC は 0.960 でした。1 に近いほど良いので良さそうには見えますが、データセット的には 1 を目指せそうな気がしています。
モデル改善
モデルの性能評価を一通り行なったところで、モデルの改善もやってみます。
性能評価の結果
| 項目 | 値 |
|---|---|
| 正解率(Accuracy) | 0.833 |
| 適合率(Precision) | 1.0 |
| 再現率(Recall) | 0.642 |
| F 値(F-measure) | 0.782 |
ロジスティック回帰の注意点で閾値の話題を出しましたが、 今回扱っている iris データセットはチュートリアル/教育用のデータであり内容はシンプルです (「1 つのクラスは他の 2 つのクラスから線形分離可能」「 ロジスティック回帰での精度の指数として 95 程度出る」とも記載がある)。 また、さらにそこから versicolor と virginica のみのデータに絞っているため、閾値の考慮はなくても良いと考えます。
つまり今回の性能評価の結果よりもモデルの精度を上げられるということになります。
多重共線性の回避
相関関係確認で、強い正の相関が出ている説明変数のペアがありました。ここを回避するため、強い正の相関が出た 2 つの説明変数のペアに共通していた「petal_length(花弁の長さ)」をデータから取り除きます。
(データセットから petal_length 列を除去し再度学習しますが、学習手順は変わらないため省略)
モデル再評価
petal_length を除去したデータで再度学習させたモデルの性能評価結果を見てみます。
| 項目 | 値(改善前) | 値(改善後) |
|---|---|---|
| 混同行列(Confusion Matrix) | [[16 0] [5 9]] | [[16 0] [0 14]] |
| 正解率(Accuracy) | 0.833 | 1.0 |
| 適合率(Precision) | 1.0 | 1.0 |
| 再現率(Recall) | 0.642 | 1.0 |
| F 値(F-measure) | 0.782 | 1.0 |
完全に判定できるまでに改善できました。
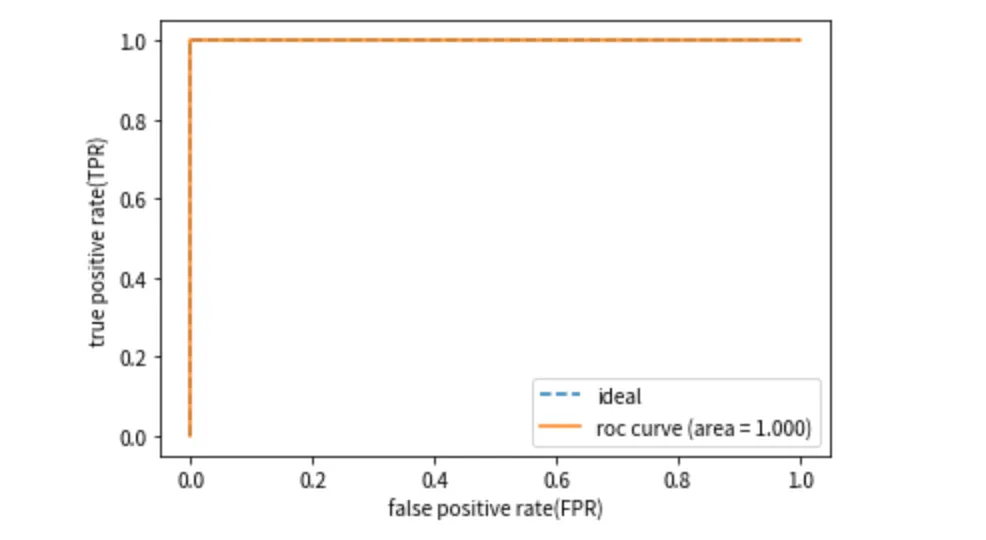
ROC 曲線も最大になっています。
シンプルなデータセット故オール満点を出せた面もありますが、多重共線性の回避が大切であることも実感できました。
まとめ
ロジスティック回帰は「クラス分類」と言われますが、「分類する」 を「判定する」「判断する」と読み替えると、色々な可能性を探れる統計手法だなと思いました。
また、ロジスティック回帰もあくまでも予測であることを忘れずに。「白黒はっきりつける」ということだけでなく「疑わしきは」(閾値)の文脈も忘れずに使っていきたいところです。
運動会や花火大会って、当日の朝の天気で開催有無が決まりますよね。
ということは気象情報データを使って、例えば過去何年分かの「運動会開催日〜過去何日分かの気象データ」と「運動会が開催されたか」のデータがあれば開催予測は立てられそうですね。
それはまた、別の機会に。