ゴルーチン(Goroutines) - Golang learning step 2-4
roadmap.sh > Go > Going Deeper > Goroutines の学習を進めていきます。
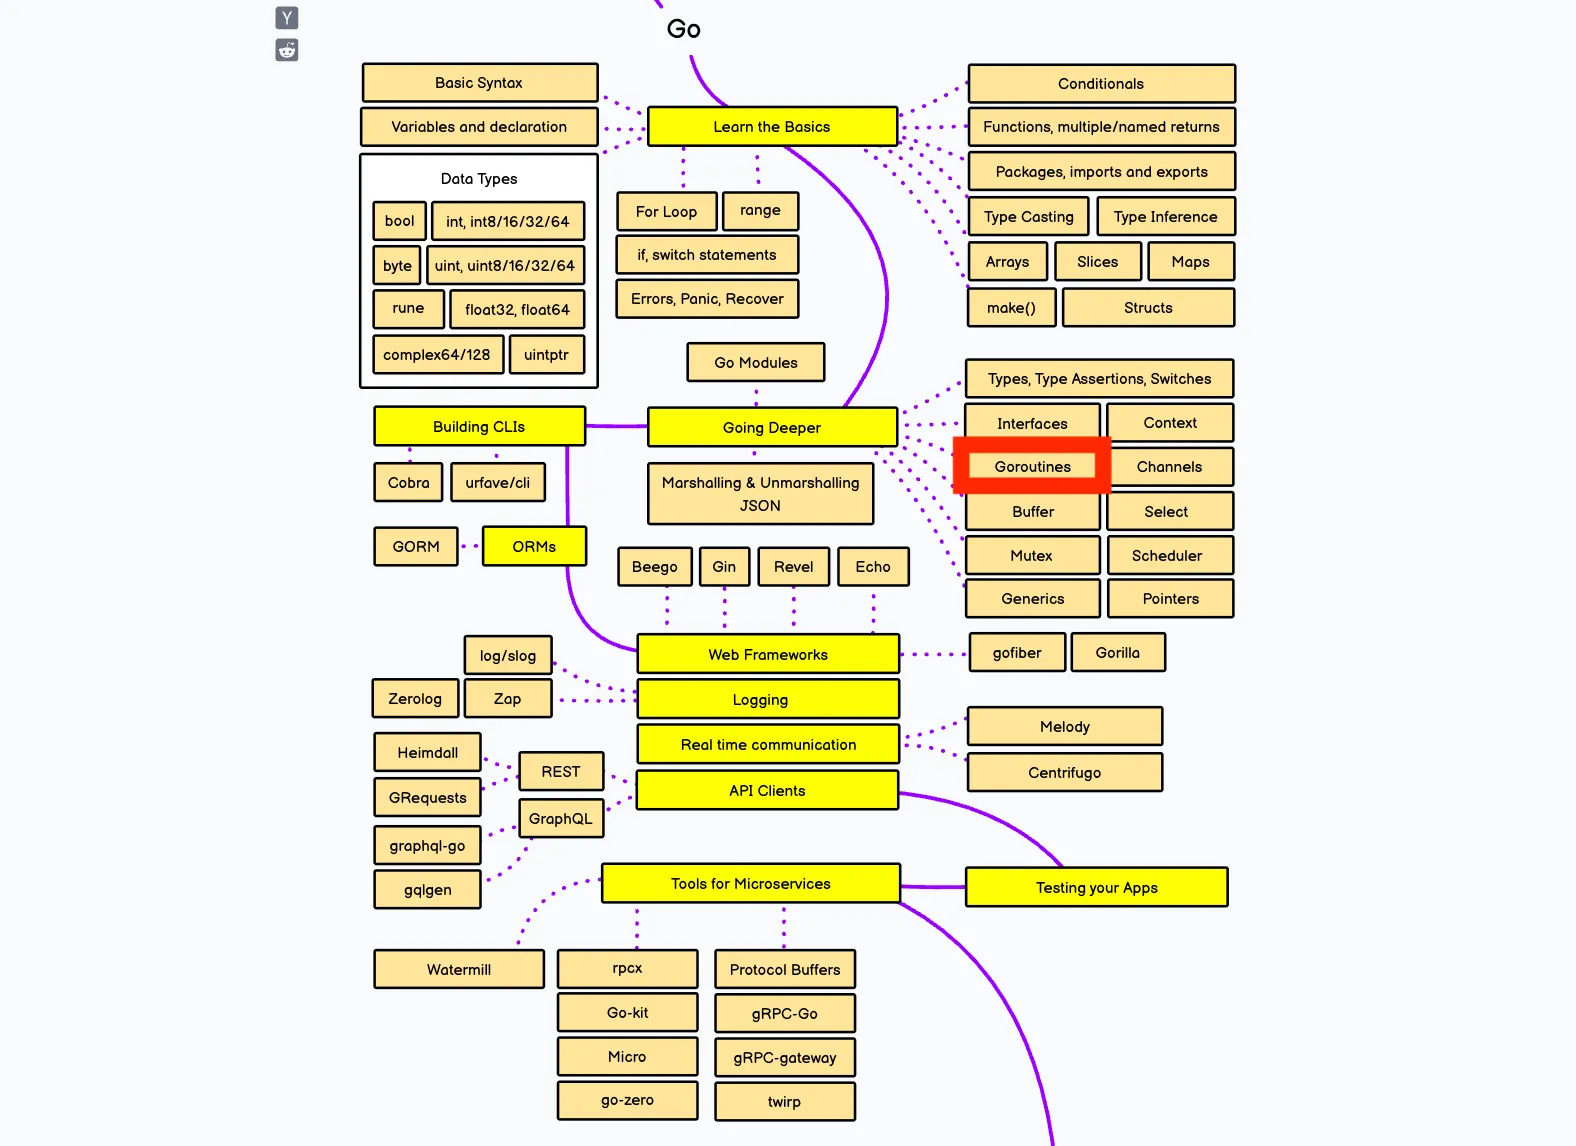
※ 学習メモとしての記録ですが、後にこのセクションを学ぶ道しるべとなるよう、ですます調で記載しています。
開発環境
- チップ: Apple M2 Pro
- OS: macOS Sonoma
- go version: go1.23.2 darwin/arm64
参考 URL
ゴルーチンを使用することで、Goで並行プログラムを書くことができます。数千件のリクエストを処理するWebサーバーや、ネットワークリクエストを同時に行いながら新しいページを表示するウェブサイトなどが、並行処理の例として挙げられます。Goでは、これらの並行タスクのことを「ゴルーチン」と呼びます。
- [official] Goroutines
- [official] Effective Go: Goroutines
- [article] Go by Example: Goroutines
- [video] GoRoutines
- [video] Understanding Concurrency
- [feed] Explore top posts about Golang
ゴルーチン(Goroutines)
ゴルーチンは、Go で並行処理を実現するための軽量スレッドのようなものです。Go は、他の多くの言語に比べて簡単に並行処理を実行できるように設計されており、ゴルーチンはこの並行処理の基本単位となります。
なお、ゴルーチンは、OS のスレッドではなく、Go ランタイムによって管理される「ユーザーレベルのスレッド」として動作します。Go ランタイムは、少ない数の OS スレッドに多くのゴルーチンを効率的に割り当てる仕組みを持っており、これにより高い並行性が実現されています。
通常の OS スレッドは、スレッドごとに数 MB のスタックメモリを確保しますが、ゴルーチンは初期スタックサイズが非常に小さく(数KB程度)、必要に応じてスタックサイズを自動的に拡張します。このため、大量のゴルーチンを生成してもメモリ消費が抑えられます。
基本形
go キーワードを使って、関数や処理を非同期で実行することができます。
// 関数の前に go キーワードを付けるだけでゴルーチンとして実行
go someFunction()

// 無名関数も同様に実行可能
go func() {
  // 処理
}()
例えば、以下のようにゴルーチンを使って関数を並行実行できます。
package main

import (
  "fmt"
  "time"
)

func sayHello() {
  fmt.Println("Hello, World!")
}

func main() {
  go sayHello()        // ゴルーチンを起動
  time.Sleep(1 * time.Second) // メイン関数が終了しないように少し待機
}
ゴルーチンの特徴
- 軽量性
- ゴルーチンは非常に軽量で、OS のスレッドに比べて多くのゴルーチンを同時に生成できます。また、メモリ消費が少なく、数万のゴルーチンを効率的に扱うことが可能です。
- コストの低いスケジューリング
- Go のランタイムは、ゴルーチンを効率的にスケジューリングし、OS のスレッド数を制限しながらも多くのゴルーチンを並行実行する仕組みを持っています。
- シンプルな構文
goキーワードを使うだけで並行処理が開始されるため、コードがシンプルで見通しが良くなります。
ゴルーチンの終了と同期
ゴルーチンは並行処理を行いますが、その終了を待たずにメイン関数が終了してしまうと、ゴルーチンも終了してしまいます。そのため、ゴルーチンを同期したり、終了を待つ必要がある場合には、チャネルや sync.WaitGroup などを利用します。
sync.WaitGroupの例
package main

import (
  "fmt"
  "sync"
)

func main() {
  var wg sync.WaitGroup

  wg.Add(1)
  go printMessage("Hello from goroutine", &wg)

  wg.Wait() // ゴルーチンが終了するのを待機
  fmt.Println("Main function ends")
}
この例では、sync.WaitGroup を使ってゴルーチンの終了を待機しています。
待機の仕組み
sync.WaitGroup は内部的にカウンターを持っており、Add(n) を呼び出すと、このカウンターが n だけ増えます。そして、各ゴルーチンが完了するたびに、defer wg.Done() でカウンターが1ずつ減ります。wg.Wait() が呼ばれたときに、このカウンターが 0 になるまで待機します。
つまり、次のような流れになります。
wg.Add(2)でカウンターが 2 になる。- 2 つのゴルーチンが非同期で起動する。
- 各ゴルーチンが完了するたびに
wg.Done()が呼ばれ、カウンターが1ずつ減少。 - 全てのゴルーチンが終了し、カウンターが0になると、
wg.Wait()の待機が解除され、次の処理に進む。
このカウンターの値によって、sync.WaitGroup が「何個のゴルーチンが終了するまで待つか」を指定しているというわけです。
主な用途
1. 並列なI/O処理
例えば、複数の API やデータベースから情報を同時に取得したい場合、ゴルーチンを使うことで効率的にリクエストを実行できます。各リクエストをゴルーチンで非同期に実行し、レスポンスを待って処理することで、全体の処理時間を短縮できます。
package main

import (
  "fmt"
  "net/http"
  "sync"
)

func fetchURL(url string, wg *sync.WaitGroup) {
  defer wg.Done()
  resp, err := http.Get(url)
  if err != nil {
    fmt.Println("Error fetching:", url, err)
    return
  }
  fmt.Println("Fetched", url, "with status", resp.Status)
}

func main() {
  var wg sync.WaitGroup
  urls := []string{"https://example.com", "https://example.org", "https://example.net"}

  for _, url := range urls {
    wg.Add(1)
    go fetchURL(url, &wg)
  }

  wg.Wait()
  fmt.Println("All URLs fetched.")
}
// 出力:
// Fetched https://example.org with status 200 OK
// Fetched https://example.com with status 200 OK
// Fetched https://example.net with status 200 OK
// All URLs fetched.
この例では、複数のURLを並行してフェッチしています。sync.WaitGroup を使用することで、全てのゴルーチンが完了するのを待ちます。
2. 並行して計算処理を行う
大量のデータを処理する際、ゴルーチンを使って計算処理を並行実行できます。これにより、CPU リソースを有効に活用し、計算時間を短縮できます。
package main

import (
  "fmt"
  "sync"
)

func sum(array []int, result *int, wg *sync.WaitGroup) {
  defer wg.Done()
  sum := 0
  for _, v := range array {
    sum += v
  }
  *result = sum
}

func main() {
  array := []int{1, 2, 3, 4, 5, 6, 7, 8, 9, 10}
  var result1, result2 int
  var wg sync.WaitGroup

  wg.Add(2) // これから開始するゴルーチンの数を引数に渡す
  go sum(array[:len(array)/2], &result1, &wg)
  go sum(array[len(array)/2:], &result2, &wg)

  wg.Wait()
  total := result1 + result2
  fmt.Println("Total sum:", total)
}
// 出力:
// Total sum: 55
この例では、配列を分割して二つのゴルーチンで計算を行い、最後に結果を合計しています。
3. チャネルを使った非同期なタスク管理
チャネルを使うと、ゴルーチン間で安全にデータをやり取りできます。例えば、ワーカープールのようなシステムでタスクを分配し、処理結果を収集する場合に役立ちます。
package main

import (
  "fmt"
  "time"
)

// ワーカー関数
// 各ワーカーは、jobsチャネルからタスクを受け取り、完了したら結果をresultsチャネルに送信します。
func worker(id int, jobs <-chan int, results chan<- int) {
  for job := range jobs {  // jobsチャネルが閉じるまでタスクを受け取る
    fmt.Printf("Worker %d processing job %d\n", id, job)
    time.Sleep(time.Second)  // 処理のシミュレーション(1秒待つ)
    results <- job * 2     // 結果をresultsチャネルに送信
  }
}

func main() {
  jobs := make(chan int, 5)  // タスクを送信するチャネル
  results := make(chan int, 5) // 結果を受け取るチャネル

  // 3つのワーカーを起動(それぞれのワーカーが並行してタスクを処理する)
  for w := 1; w <= 3; w++ {
    go worker(w, jobs, results)
  }

  // 5つのタスクをjobsチャネルに送信
  for j := 1; j <= 5; j++ {
    jobs <- j
  }
  close(jobs)  // タスクの送信が完了したのでjobsチャネルを閉じる

  // 5つの処理結果を受け取る
  for a := 1; a <= 5; a++ {
    result := <-results
    fmt.Println("Result:", result)
  }
}
- jobs チャネルと results チャネル
jobsは、タスクをワーカーに渡すためのチャネルです。5つのタスクを順に追加し、close(jobs)で「新しいタスクがもうない」ことをワーカーに知らせています。resultsは、ワーカーが処理した結果を返すためのチャネルです。5 つのタスクの処理結果をこのチャネルから受け取ります。
- ワーカー関数
worker関数は、jobsチャネルからタスクを取り出し、それを処理します(ここでは1秒待つことで処理をシミュレーションしています)。- 処理が終わると、その結果を
resultsチャネルに送ります。
- 並行して実行されるワーカー
for w := 1; w <= 3; w++ { go worker(w, jobs, results) }の部分で3つのワーカーをゴルーチンとして起動しています。これにより、複数のタスクが同時に処理され、効率が良くなります。
- 結果の受け取り
for a := 1; a <= 5; a++ { result := <-results }でresultsチャネルから 5 つの結果を受け取り、処理が完了していることを確認しています。
Worker 3 processing job 1
Worker 1 processing job 2
Worker 2 processing job 3
Worker 2 processing job 4
Worker 3 processing job 5
Result: 6
Result: 2
Result: 4
Result: 10
Result: 8
この例では、3 つのワーカー(ゴルーチン)で 5 つのタスクを並行して処理し、resultsチャネルで処理結果を受け取っています。複数のタスクを同時に処理する場合に、このようにゴルーチンとチャネルを組み合わせると便利です。
4. タイムアウト処理
外部 API などの I/O 待ちにタイムアウトを設定したい場合、ゴルーチンとチャネル、select 文を使ってタイムアウト処理を実装できます。
package main

import (
  "fmt"
  "time"
)

func doTask(done chan bool) {
  time.Sleep(2 * time.Second)  // タスクが完了するまで2秒かかる
  done <- true
}

func main() {
  done := make(chan bool, 1)
  go doTask(done)

  select {
  case <-done:
    fmt.Println("Task completed")
  case <-time.After(1 * time.Second):
    fmt.Println("Task timed out")
  }
}
この例では、タスクが 1 秒以内に完了しなければ「Task timed out」と表示され、完了すれば「Task completed」と表示されます。
ゴルーチン使用の注意点
1. ゴルーチンの終了管理
ゴルーチンは非同期に実行されるため、予期しないタイミングで終了することがあります。ゴルーチンが完了するのを正確に待つには、sync.WaitGroup などを使って終了を管理する必要があります。
var wg sync.WaitGroup
wg.Add(1)
go func() {
  defer wg.Done()
  // ゴルーチンの処理
}()
wg.Wait() // 全てのゴルーチンが完了するのを待つ
2. ゴルーチンリーク(ゴルーチンが終了しない)
一部のゴルーチンが終了せずに実行され続ける「ゴルーチンリーク」が発生することがあります。特に、チャネルを使う場合に、チャネルが閉じられずゴルーチンが range でブロックされたり、select 文のケースが実行されずに待機したままになったりすることが原因です。ゴルーチンが不要になったら、正しく終了するように設計する必要があります。
次のコードは、ゴルーチンがチャネルの受信待機でブロックされ、終了しない(特定のゴルーチンが処理を続けられない状態)例です。
package main

import (
  "fmt"
  "time"
)

func leakyGoroutine(ch <-chan int) {
  for val := range ch {
    fmt.Println("Received:", val)
  }
  fmt.Println("Goroutine exiting")
}

func main() {
  ch := make(chan int)

  go leakyGoroutine(ch)

  time.Sleep(1 * time.Second)
  // ここで何も送信せずに終了する
  fmt.Println("Main function ending")
}
上記のコードでは、leakyGoroutine が ch チャネルからの値を受け取ることを待機しています。しかし、メイン関数でチャネルに値を送信しないまま終了しているため、leakyGoroutine は ch チャネルからの値を待ち続ける状態でブロックされ、処理が完了できないままになります。この状態が「ゴルーチンリーク」と呼ばれる問題です。leakyGoroutine は、チャネルが閉じられない限り正常に終了できません。
ここではゴルーチンの処理が終了していないのにプログラムが終了してしまうことが問題であり、Go では、メイン関数が終了すると、メイン関数から起動したすべてのゴルーチンも強制的に終了します。そのため、意図したゴルーチンの処理が完了していないにもかかわらずプログラムが終了することが起こります。
このような状況では、重要な処理が完了せずに中断されたり、ゴルーチンがリソースを解放する前に終了することで、予期しない動作やデータの不整合が発生する可能性があります。
たとえば、API のデータ取得やファイル書き込みなど、完了すべき処理をゴルーチンで実行している場合に、メイン関数が先に終了すると、その途中でゴルーチンが中断され、処理が正しく完了しません。
この問題を防ぐために、sync.WaitGroup を使って、メイン関数がゴルーチンの処理が完了するまで待機するようにします。
package main

import (
  "fmt"
  "sync"
  "time"
)

func fetchData(wg *sync.WaitGroup) {
  defer wg.Done() // 完了を通知する
  time.Sleep(2 * time.Second)
  fmt.Println("Data fetched")
}

func main() {
  var wg sync.WaitGroup
  wg.Add(1) // ゴルーチンの数を追加

  go fetchData(&wg)

  wg.Wait() // すべてのゴルーチンが完了するまで待機
  fmt.Println("Main function ending")
}
このコードでは、sync.WaitGroup によって fetchData の完了を待機するため、Data fetched が表示され、ゴルーチンの処理が完了してからメイン関数が終了します。
3. 競合状態(レースコンディション)
複数のゴルーチンが同じ変数やリソースにアクセスすると、競合状態が発生し、不正なデータや予期しない挙動が起こる可能性があります。競合を避けるには、以下のような対策が必要です。
- チャネルを使ってデータのやり取りを行い、同時アクセスを防ぐ。
sync.Mutexなどのロック機構を使用して、共有リソースへのアクセスを制御する。
var mu sync.Mutex
counter := 0

mu.Lock()     // ロックを取得
counter += 1  // 共有リソースへのアクセス
mu.Unlock()   // ロックを解放
4. チャネルの閉じ方
チャネルを使う場合、送り手側がチャネルを閉じる責任があります。チャネルを閉じないと受け手がブロックされ続ける可能性がある一方で、複数のゴルーチンがチャネルを閉じようとするとパニックが発生します。チャネルを閉じるのは1回のみであるべきです。
5. メモリリーク
ゴルーチンが不要になった後も、他のゴルーチンやリソースへの参照が残っていると、メモリリークが発生します。特に、チャネルや外部リソースに依存するゴルーチンが終了しないと、無駄にメモリが消費され続ける可能性があります。
6. ゴルーチンの生成制御
ゴルーチンは軽量ですが、無限に生成するとシステムに負荷がかかり、パフォーマンスが低下します。例えば、ループ内でゴルーチンを生成する場合、意図せずに数千以上のゴルーチンが生成されてしまうことがあります。必要に応じて、ワーカープールのような方法でゴルーチンの数を制御することが推奨されます。
(3. チャネルを使った非同期なタスク管理のサンプルコードを参照)
7. タイムアウトとキャンセル
長時間実行されるゴルーチンには、キャンセルやタイムアウトを設けることが重要です。Go では context パッケージを使って、ゴルーチンのキャンセルを管理する方法があります。これにより、特定の条件でゴルーチンをキャンセルし、無駄な処理を防ぐことができます。
import (
  "context"
  "time"
)

func main() {
  ctx, cancel := context.WithTimeout(context.Background(), 2*time.Second)
  defer cancel()

  go func(ctx context.Context) {
    select {
    case <-ctx.Done():
      fmt.Println("ゴルーチンがキャンセルされました:", ctx.Err())
    }
  }(ctx)
}
8. パニック処理
ゴルーチン内でパニックが発生すると、エラーメッセージが表示されてゴルーチンが終了しますが、メインプログラムがそのまま続行されることがあります。これを防ぐため、recover を使ってゴルーチン内でパニックが発生した際の処理を行うのが良い習慣です。
go func() {
  defer func() {
    if r := recover(); r != nil {
      fmt.Println("パニックが発生しました:", r)
    }
  }()
  // ここで処理が行われる
}()
ゴルーチン内でパニックが発生すると、そのゴルーチンはエラーメッセージを出力して強制終了されます。しかし、メイン関数や他のゴルーチンには影響がないため、パニックを適切に処理しておかないと、ゴルーチン内での処理が完了しないままプログラムが続行され、予期しない動作やリソースリークが発生する可能性があります。
これを防ぐためには、recover 関数を使ってゴルーチン内のパニックをキャッチし、エラーメッセージをログに記録したり、後続の処理に影響が出ないように対処します。
package main

import (
  "fmt"
  "time"
)

func safeGoroutine() {
  defer func() {
    if r := recover(); r != nil { // パニックをキャッチ
      fmt.Println("Recovered from panic:", r) // ログに記録する
    }
  }()

  fmt.Println("Goroutine started")
  time.Sleep(1 * time.Second)
  panic("Something went wrong!") // パニック発生
  fmt.Println("This line will not execute")
}

func main() {
  go safeGoroutine() // パニック処理があるゴルーチンを起動

  // メイン関数の処理を続行
  time.Sleep(2 * time.Second) // ゴルーチンが終了するのを待つ
  fmt.Println("Main function completed")
}
safeGoroutine関数内で、deferを使って匿名関数(func())を定義しています。- この匿名関数は、ゴルーチン終了時に実行され、
recoverでパニック状態をキャッチします。
- この匿名関数は、ゴルーチン終了時に実行され、
panic("Something went wrong!")でパニックを意図的に発生させています。- 通常、パニックが発生するとプログラム全体が終了しますが、
recoverを使うことで、パニックをキャッチし、後続の処理への影響を最小限に抑えています。
- 通常、パニックが発生するとプログラム全体が終了しますが、
recoverがパニックをキャッチすると、Recovered from panic: Something went wrong!が出力され、ゴルーチン内のパニックが安全に処理されます。safeGoroutine内でパニックを処理したため、メイン関数は正常に終了し、Main function completedが出力されます。
recover を使う際の注意点
recoverはパニック発生時のみ機能します。通常のエラーハンドリングには使用できません。deferとセットで使用する必要があります。deferで定義された関数内でしかrecoverを呼び出せないため、ゴルーチン内でパニック処理が必要な場合は必ずdeferを使って関数を定義します。
エラーメッセージのログを取ることで、デバッグやエラー解析が容易になります。
パニック発生時のリカバリ戦略
- エラーログの記録: 何が原因でパニックが発生したかを把握するため、エラーメッセージやスタックトレースをログに残します。
- 通知やリトライ処理: ゴルーチン内で特定の処理が重要である場合、通知を行ったり、リトライの仕組みを追加することも検討します。
- プログラムの継続: 必要であれば、代替処理を実行するか、安全にプログラムを終了させるように設計します。
まとめ
- ゴルーチンの軽量性
- Go ランタイムが管理するユーザーレベルのスレッドで、少ないメモリで効率的な並行処理を実現できる。
- 簡単な使い方
goキーワードを使うだけで簡単に非同期処理を開始できる。
- 同期の重要性
- ゴルーチンの終了を待つ必要がある場合には、
sync.WaitGroupやチャネルを使って同期処理を行う。
- ゴルーチンの終了を待つ必要がある場合には、
- チャネルでのデータのやり取り
- ゴルーチン間で安全にデータをやり取りするためにチャネルを利用できる。
- 並行処理の用途
- 並行した I/O 処理や計算処理などで、ゴルーチンを活用することでパフォーマンス向上が期待できる。
- 注意すべき点
- ゴルーチンリークを避けるために、ゴルーチンの終了管理を徹底する。
- タイムアウトやキャンセル処理を設けることで無駄な処理を防ぐ。
- パニック発生時には
recoverを使って適切にリカバリ処理を行う。